CAPABILITY // 01
多头潜在注意力 (MLA)
创新的低秩压缩投影架构,大幅压减超长上下文推理的 KV Cache 显存占用,将单机并发吞吐提升数倍。
KV CACHE 压缩比 > 93%
围绕大规模复杂数理证明、工程架构重构与长文本深度推演。突破性引入多头潜在注意力(MLA)显存压缩架构与无人工冷启动的纯强化学习(Pure RL),以极低算力成本赋能下一代全自主智能系统。
四大原创技术攻坚打破算力调度瓶颈,重塑大规模上下文与逻辑推演基准。
创新的低秩压缩投影架构,大幅压减超长上下文推理的 KV Cache 显存占用,将单机并发吞吐提升数倍。
摆脱传统海量人工 SFT 依赖,模型在大规模数学证明与代码调试中自发演进出假设推翻、边界反思与形式化检验。
总参数 671B 仅需动态激活约 37B,无辅助损失的自平衡算法确保专家专业化调度,算力效率极致优化。
单次会话支持吞吐数十万字整套工程代码库或学术专著,结合存储级感知缓存,输入命中价格降至 0.14 元/百万 Tokens。
依托强大的逻辑自省与海量上下文窗口,精准覆盖复杂研发与专业推理全流程。
全面理解多语言微服务调用链路,自主追踪竞态死锁与内存越界漏洞,并生成严格可编译的修复 Patch。
在 AIME、Math500 等顶级数学基准集中进行深层树状假设搜索,自动推演反例并构造严谨归纳法证明。
依托原生 128K 超长上下文,对数百页投融资协议与法律法规展开逐条风险溯源与违约陷阱标定。
深度挖掘订单流脉冲与宏观经济指标非线性耦合关系,构建防御极端尾部风险的多因子稳健策略体系。
在沙箱环境中自主调用编译器、执行测试用例并根据报错自适应回溯修补,实现全天候自主软件工程研发。
全面兼容 Ollama 与 vLLM,支持企业在隔离内网硬件集群上一键拉取开源蒸馏权重,核心知识产权 100% 物理留存。
根据业务场景对推演严谨度、首字吞吐与成本控制的不同要求灵活选型。
原生强化学习深度自省模型,支持显式思维链逐步验证。在高等数学竞赛、逻辑博弈与安全漏洞攻防测试中表现卓越。
多任务通用旗舰底座,在常识问答、长篇翻译、指令遵循与工程文档生成中兼具毫秒级首字延迟与超高输出稳定性。
基于 R1 优质推演数据蒸馏微调而成,1.5B ~ 70B 涵盖单卡端侧与企业集群,支持 Ollama 与 llama.cpp 无网络离线运行。
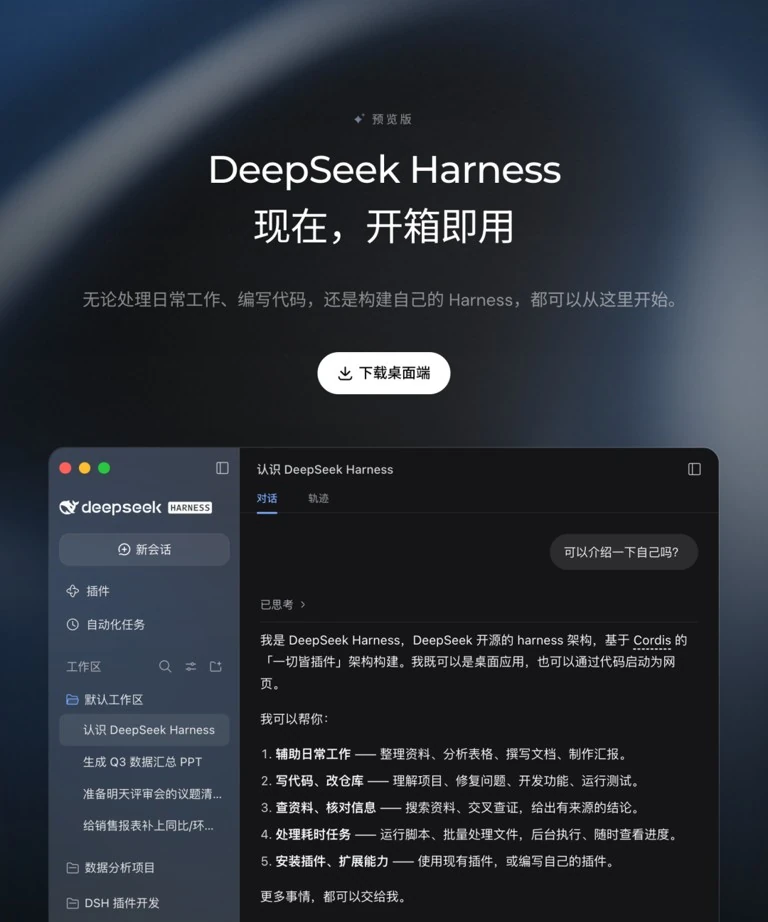
DeepSeek 遵循标准 REST 协议,现有技术栈无需对业务核心代码进行任何改动。仅需更换 Base URL 并配置专属密钥,即可平滑切换至高可用算力网关。
无论您是通过浏览器轻量推演、命令行自动化调用,还是在私有化机房开展敏感课题研究,DeepSeek 均提供针对性的交互体验与稳定性支撑。
硬核数据衡量推理实力,所有评测结果均可通过标准开源套件复现。
系统解答关于 DeepSeek 网页版入口、API 价格收费标准与开源技术细节。
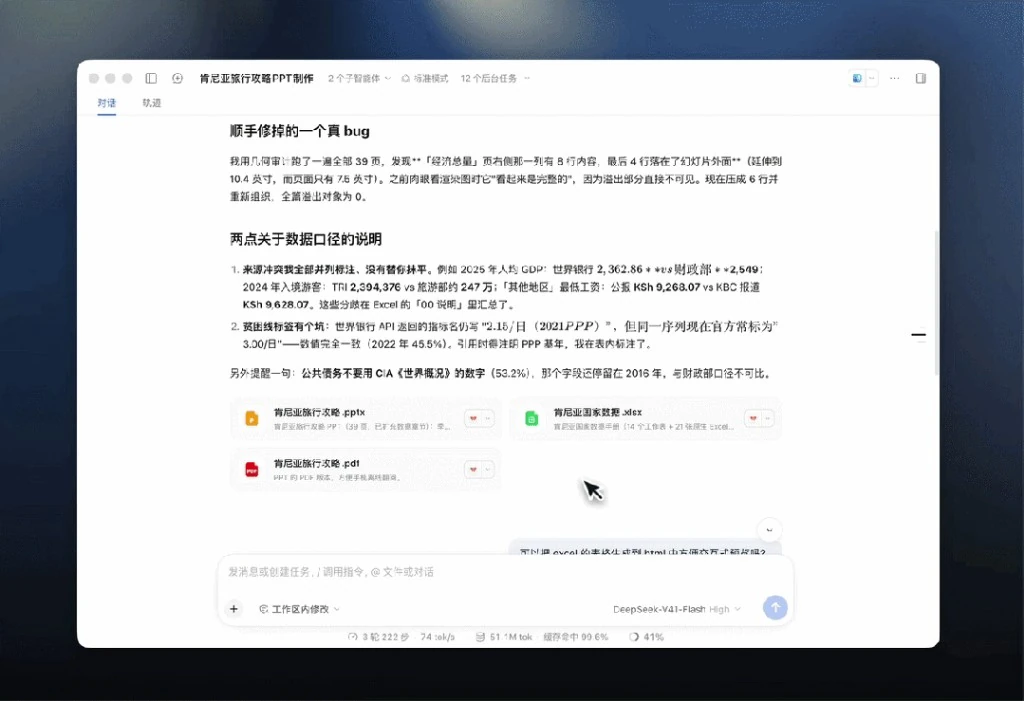
实时关注 DeepSeek 基础算法迭代、开源动态与工程支持通告。